


크롤링 프로그램 개발 사례, Web of Science 논문 데이터 수집
우리비엔씨는 2015년 11월부터 12월까지 한양대학교 ERICA캠퍼스 LINC사업단의 ‘연구데이터 수집 프로그램’을 개발했습니다. Web of Science에서 연구기관명으로 검색한 국제논문 데이터를 500건 단위로 자동으로 내려받는 크롤링 프로그램과, 내려받은 파일의 저자·주소(C1) 칸을 저자·대학·소속·주소로 나눠 하나의 결과 파일로 합치는 가공 기능을 함께 만들었습니다. 학교의 연구·산학협력 실적을 정리하는 담당자가 반복 다운로드와 엑셀 수작업 없이 같은 규칙으로 정리된 논문 데이터를 얻도록 한 웹 데이터 수집 자동화 사례입니다.
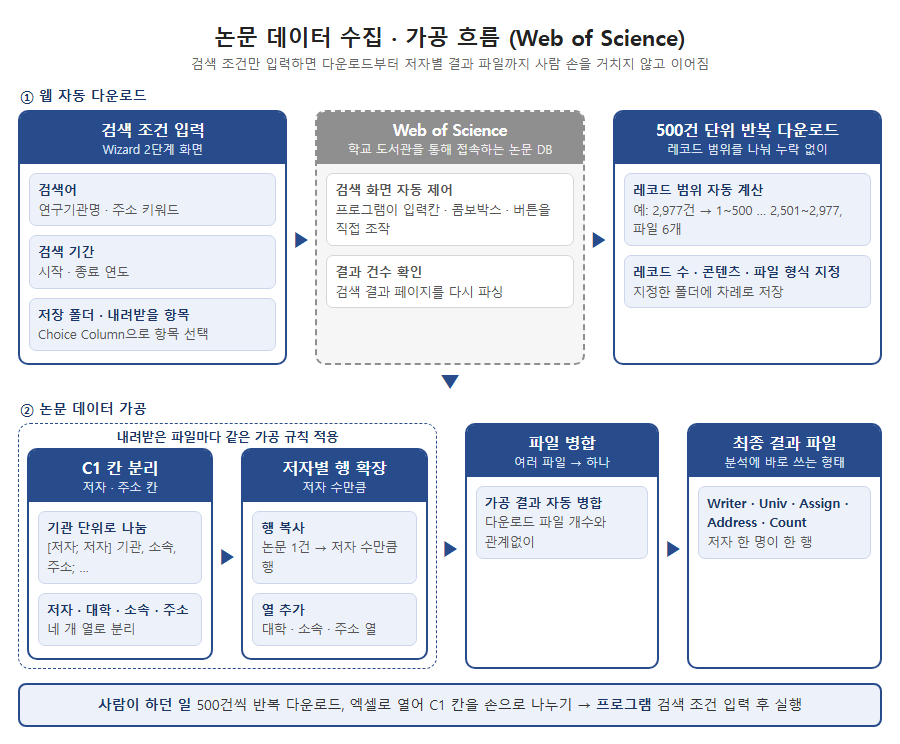
논문 데이터 수집·가공 흐름. 회색은 외부 사이트(Web of Science), 파란색은 우리비엔씨가 개발한 부분입니다.
크롤링 프로그램 개발 배경
LINC사업단은 학교의 연구·산학협력 정보를 모으고 관리하는 일을 맡고 있었습니다. 그중 국제논문 실적은 Web of Science에서 직접 내려받아 정리했는데, 이 과정이 거의 전부 손으로 이루어졌습니다. 2015년 10월 LINC사업팀이 낸 제안요청서에 적힌 사업 목적도 연구·산학협력 정보의 수집을 자동화하고, 수집된 자료의 신뢰성을 높이는 것이었습니다. 우리비엔씨는 제안서를 제출해 선정되었습니다.
고객이 보내 준 기존 작업 순서는 다음과 같았습니다.
| 순서 | 기존 수작업 |
|---|---|
| 1 | 학교 도서관 홈페이지를 거쳐 Web of Science 접속 |
| 2 | 기관명 키워드를 입력하고 검색 필드(연구기관명 및 주소)와 기간 선택 |
| 3 | 결과 건수 확인 |
| 4 | 500건씩 범위를 바꿔 가며 반복 다운로드 (예: 2,977건이면 1~500, 501~1,000 … 2,501~2,977로 파일 6개) |
| 5 | 내려받은 텍스트 파일을 엑셀로 열어 저자·주소(C1) 칸을 저자, 대학, 소속, 주소로 직접 나누고 저자 수만큼 행 추가 |
건수가 늘수록 범위를 바꿔 입력하는 횟수가 늘고, 범위를 하나 건너뛰거나 겹치게 받아도 알아차리기 어렵습니다. 엑셀에서 C1 칸을 나누는 일은 논문마다 저자 수와 기관 수가 달라 일정한 규칙으로 하기 더 어려웠습니다. 수집 자동화와 함께 “자료의 신뢰성”이 사업 목적에 들어간 이유입니다.
논문 데이터 수집 및 가공 방식
1. 웹 자동 다운로드
프로그램은 Web of Science 검색 화면의 구조를 파싱해, 기본 검색어 입력칸(텍스트박스), ‘연구기관명 및 주소’ 검색 필드(콤보박스), 검색 버튼을 직접 다룹니다. 사람이 마우스로 클릭하는 것과 같은 동작을 프로그램이 대신하는 웹 자동화 방식입니다. 사용자는 검색어, 검색 기간(시작·종료 연도), 저장 폴더만 정하고, 필요하면 내려받을 항목을 고릅니다(Choice Column).
검색이 끝나면 결과 페이지를 다시 파싱해 전체 건수를 읽고, 그 건수에 맞춰 레코드 범위를 500건씩 나눕니다. 범위마다 레코드 수, 레코드 콘텐츠, 파일 형식을 지정해 저장하기 때문에 마지막 범위까지 빠짐없이, 겹치지 않게 내려받습니다.
2. 논문 데이터 분리 및 병합 규칙
내려받은 파일은 모두 같은 가공 규칙을 거칩니다. 핵심은 C1 칸입니다. C1에는 “[저자; 저자] 기관, 소속, 주소” 묶음이 기관 수만큼 이어져 한 셀에 들어 있습니다. 프로그램은 이 칸을 대학(기관) 단위로 나누고, 저자 수만큼 행을 만든 뒤 대학·소속·주소 열을 붙입니다. 아래는 가상의 이름으로 다시 그린 예시입니다.
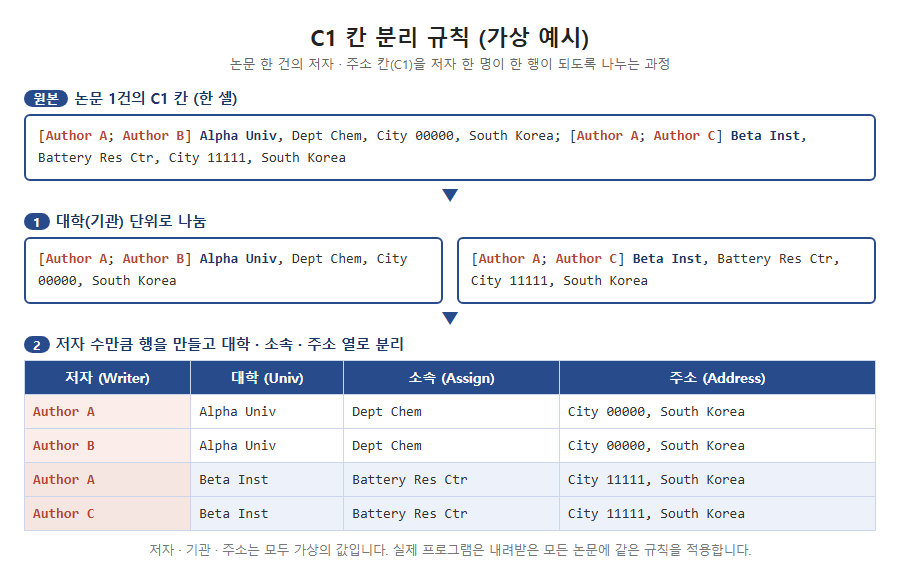
C1 칸 분리 규칙. 저자·기관·주소는 모두 가상의 값입니다.
같은 저자가 두 기관에 소속되어 있으면 기관마다 한 행씩 생깁니다. 이렇게 파일별로 가공한 결과를 마지막에 하나로 병합해 최종 결과 파일을 만듭니다. 다운로드 파일이 6개든 그 이상이든 과정은 같고, 중간에 사람이 엑셀을 열 일이 없습니다.
Wizard 4단계 화면 구성
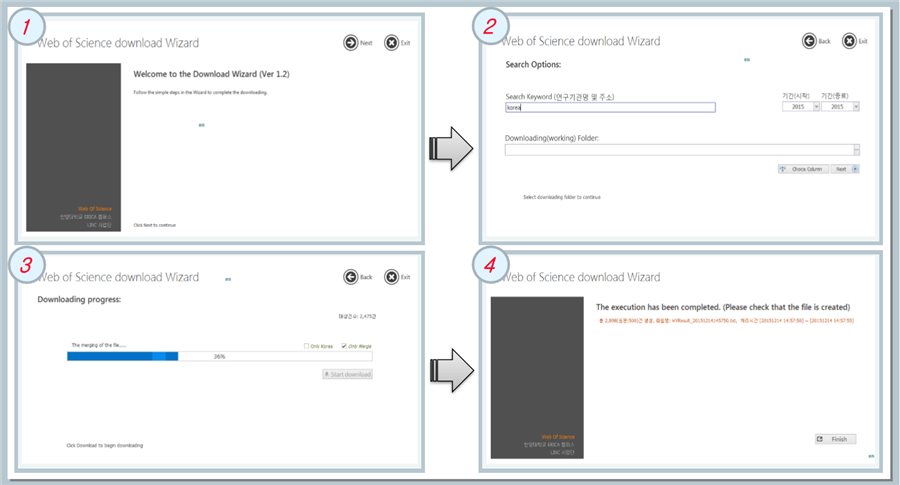
Web of Science download Wizard의 4단계 화면. (2015년 12월 완료보고서의 화면 매뉴얼)
프로그램을 처음 쓰는 담당자도 순서를 놓치지 않도록 Wizard 방식으로 만들었습니다. 각 단계에서 할 일이 하나씩만 보입니다.
| 단계 | 화면 | 하는 일 |
|---|---|---|
| 1 | 시작 | 프로그램 안내 (Ver 1.2) |
| 2 | 검색 조건 | 검색어(연구기관명 및 주소), 기간(시작·종료 연도), 저장 폴더, 내려받을 항목 선택 |
| 3 | 다운로드 진행 | 대상 건수와 진행률 표시, 다운로드 후 파일 병합 |
| 4 | 완료 안내 | 생성 건수, 결과 파일명, 처리 시간 표시 |
설치는 InstallShield로 만든 Setup 파일로 배포했고, 사용자 PC는 Windows XP 이상에 .NET Framework 4.0이 있으면 됩니다.
결과 파일 구성
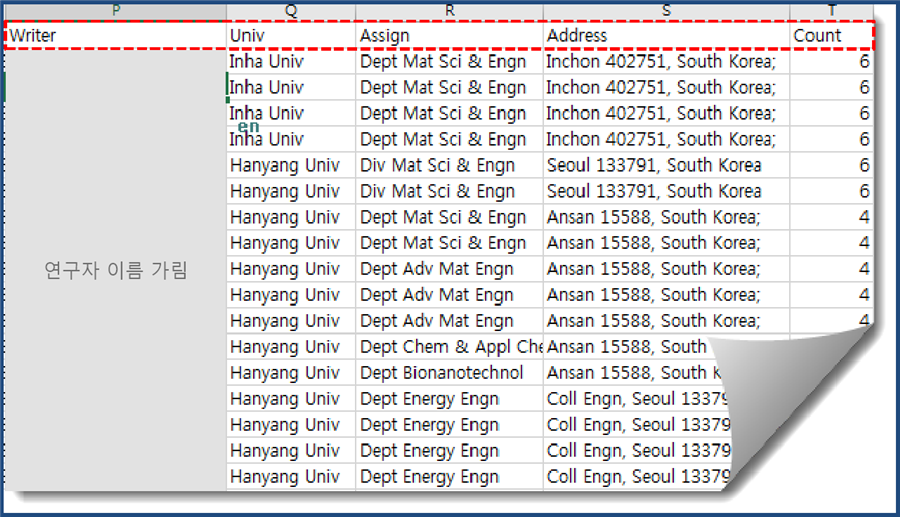
최종 결과 파일. 저자 한 명이 한 행이 되도록 정리됩니다. (연구자 이름 가림)
결과 파일은 저자(Writer), 대학(Univ), 소속(Assign), 주소(Address) 열과 Count 열로 구성됩니다. 저자와 기관이 열로 나뉘어 있어 기관별, 학과별로 바로 필터하거나 집계할 수 있습니다. 완료보고서에는 “모든 과정은 자동으로 수행되며 수작업을 수반하지 않습니다”라고 정리했습니다.
프로젝트 개요
| 항목 | 내용 |
|---|---|
| 고객 | 한양대학교 ERICA캠퍼스 LINC사업단 (LINC사업팀) |
| 사업명 | 한양대학교 ERICA캠퍼스 LINC사업단 ‘연구데이터 수집 프로그램’ 개발 |
| 기간 | 2015.11 ~ 2015.12 (12월 검수, 완료보고) |
| 수주 | 제안요청서 공고 후 제안서 제출, 선정 |
| 수행 | 웹 자동 다운로드, 논문 데이터 가공·병합, 설치 파일, 납품까지 우리비엔씨 |
| 대상 사이트 | Web of Science (학교 도서관을 통해 접속) |
| 주요 기능 | 검색 화면 자동 제어, 결과 건수에 맞춘 500건 단위 반복 다운로드, 내려받을 항목 선택, C1 칸 분리(저자·대학·소속·주소), 저자별 행 확장, 파일 자동 병합, Wizard 4단계 화면 |
| 개발 환경 | Visual Studio 2012 C#, .NET Framework 4.0, DevExpress 15.1, InstallShield (사용자 PC: Windows XP 이상) |
| 산출물 | 프로그램, 소스코드, 개발 보고서(사용자 매뉴얼 포함), 무상 유지보수 1년 |
| 이 글에 싣지 않은 것 | 사업 예산·계약 금액, 담당자 이름, 결과 파일 속 연구자 이름 (화면에서 가림) |
자주 묻는 질문
Q. 크롤링 프로그램은 어떤 사이트든 만들 수 있나요?
기술적으로는 화면 구조를 파싱해 입력칸과 버튼을 다루는 방식으로 많은 사이트를 자동화할 수 있습니다. 다만 개발 전에 수집 대상 사이트의 이용 약관을 확인하고, 공식 내보내기(Export) 기능이나 API가 있는지 먼저 살펴 그 범위 안에서 자동화하는 것이 원칙입니다. 이 사례도 학교가 이용하는 Web of Science의 검색과 내보내기 기능을 사람 대신 조작하는 방식이었습니다.
Q. 사이트 구조가 바뀌면 프로그램은 어떻게 되나요?
화면 구조를 읽어 제어하는 방식은 대상 사이트의 화면이나 항목 이름이 바뀌면 그 부분을 고쳐야 합니다. 그래서 웹 자동화 프로그램은 유지보수 조건을 함께 정해 두는 것이 좋고, 이 프로젝트도 무상 유지보수 1년을 두었습니다. 공식 API가 제공되는 사이트라면 화면 변경의 영향을 덜 받는 쪽으로 설계할 수 있습니다.
Q. 수집한 데이터를 엑셀 파일이 아니라 DB로 쌓을 수 있나요?
쌓을 수 있습니다. 이 프로젝트의 결과물은 파일이었지만, 같은 분리 규칙을 거친 데이터를 데이터베이스 테이블에 넣으면 연도별·기관별·학과별 집계를 바로 뽑을 수 있습니다. 여러 원천의 데이터를 DB로 모아 집계하는 방식은 데이터 자동 집계 프로그램 개발 사례에 정리했습니다.
Q. 검색 결과가 수천 건이어도 한 번에 받을 수 있나요?
이 프로그램은 결과 건수를 먼저 읽은 뒤 레코드 범위를 500건씩 나눠 차례로 내려받고, 마지막에 하나로 합칩니다. 고객이 손으로 하던 500건 단위를 그대로 따르면서, 범위를 빠뜨리거나 겹치게 받는 실수를 없앤 것입니다. 사용자 입장에서는 검색 조건을 넣고 한 번 실행하는 것으로 끝납니다.
함께 보면 좋은 개발 사례
- 통계 지표 데이터베이스 구축: 과학기술 국제협력 스코어보드
- 데이터 자동 집계 프로그램 개발 (원천 데이터 유형별 사례)
- 업무 전산화 프로그램 개발, 엑셀 수작업에서 벗어나는 순서
- 분석 프로그램 개발 의뢰 전 꼭 확인할 질문들
- 인천테크노파크 업체별 맞춤 메일 자동 발송 시스템 개발 사례
작성: 우리비엔씨 대표 이완종 (KOSA 특급기술자)
홈페이지: https://www.wooribnc.com
연락처: 070-4809-7769 // 0 1 0 - 5 1 7 7 - 8 0 5 5
이메일: admin@wooribnc.com // lwjvegas@gmail.com
- KOSA 소프트웨어사업자 등록업체
- KOSA 소프트웨어기술자경력 특급기술자, 정보처리기사
- 가천대학교 가족회사 협약업체
Tags: #크롤링프로그램개발 #웹데이터수집자동화 #논문데이터수집 #WebofScience #연구데이터수집프로그램 #웹자동화 #한양대학교ERICA #우리비엔씨
